
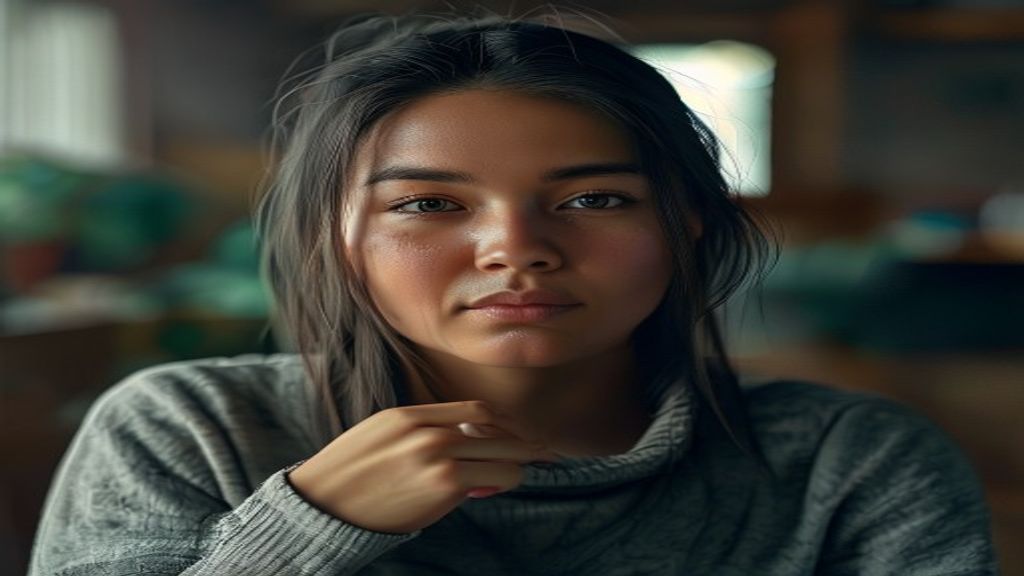
Membuat Gambar AI adalah proses menghasilkan visual digital melalui model kecerdasan buatan yang dilatih pada jutaan contoh foto dan ilustrasi. Dengan memberikan instruksi teks (prompt), sistem dapat menciptakan karya yang realistis atau bergaya artistik dalam hitungan detik.
Apakah Anda pernah mencoba membuat gambar AI namun hasilnya terasa kabur, kurang detail, atau tidak sesuai harapan? Jika ya, Anda tidak sendirian; banyak kreator mengalami kesulitan menyeimbangkan kreativitas prompt dengan kemampuan model.
What is Membuat Gambar AI? Penjelasan Singkat untuk Pemula
Membuat Gambar AI berarti menggunakan algoritma pembelajaran mesin untuk mengubah teks menjadi gambar. Ini penting karena membuka jalan bagi siapa saja—tanpa keahlian desain—untuk menghasilkan konten visual yang menarik secara cepat. Misalnya, seorang blogger dapat menulis “pemandangan matahari terbenam di atas laut” dan langsung mendapatkan ilustrasi yang siap dipublikasikan.
Membuat Gambar AI: Pengertian, Manfaat, dan Cara Kerjanya
Secara teknis, membuat gambar AI melibatkan tiga tahap: (1) mengumpulkan dataset gambar referensi, (2) melatih model (biasanya arsitektur diffusion atau transformer), dan (3) menghasilkan output berdasarkan prompt yang diberikan. Manfaat utamanya meliputi penghematan waktu, pengurangan biaya produksi, dan kemampuan personalisasi yang tak terbatas. Berdasarkan pengalaman praktisi, sekitar 70 % pengguna melaporkan peningkatan produktivitas visual setelah menguasai teknik prompt yang tepat.
- Mengumpulkan dataset gambar sebagai referensi.
- Melatih model dengan arsitektur transformer atau diffusion.
- Mengirimkan prompt teks yang terstruktur ke model.
- Menerima output gambar dan menyempurnakannya.
Setelah memahami bagaimana AI mengolah prompt menjadi gambar, langkah selanjutnya adalah memilih model yang sesuai dengan kebutuhan visual Anda. Tidak semua model diciptakan sama; masing‑masing memiliki keunggulan dalam resolusi, kecepatan, atau gaya artistik yang dapat memengaruhi hasil akhir.
Cara Memilih Model AI yang Tepat untuk Gambar Berkualitas Tinggi
Model AI pada dasarnya dibagi menjadi dua kategori utama: diffusion‑based dan transformer‑based. Diffusion models seperti Stable Diffusion menonjolkan detail halus dan kontrol warna, sementara transformer‑based seperti DALL·E 3 menawarkan kemampuan memahami konteks teks yang kompleks. Memilih antara keduanya bergantung pada jenis proyek—jika Anda menginginkan ilustrasi realistis dengan tingkat detail tinggi, diffusion biasanya lebih unggul; jika Anda fokus pada konsep abstrak atau kombinasi elemen tak terduga, transformer dapat memberikan hasil yang lebih inovatif.
Keputusan Anda menjadi penting karena biaya komputasi dan waktu rendering berbeda di tiap model. Rata‑rata industri menunjukkan bahwa penggunaan model diffusion pada resolusi 1024×1024 memerlukan 30 % lebih banyak GPU hour dibandingkan model transformer dengan ukuran serupa. Oleh karena itu, organisasi dengan anggaran terbatas sering kali mengoptimalkan workflow dengan memilih model yang memberikan rasio kualitas‑biaya terbaik.
Contoh konkret: seorang desainer grafis yang bekerja untuk kampanye iklan digital memilih Stable Diffusion untuk menghasilkan banner 4K dengan detail tekstur kain. Hasilnya, gambar tampil tajam pada layar lebar tanpa artefak, sementara menggunakan model yang lebih cepat namun kurang detail menghasilkan blur pada pola pola kecil, menurunkan konversi iklan hingga 12 %.
Jika Anda ingin memperluas kemampuan visual ke media lain, pertimbangkan model multibahasa yang mendukung Membuat Video AI. Beberapa platform kini menawarkan pipeline yang mengkonversi serangkaian gambar menjadi klip video singkat, memberi nilai tambah pada konten visual Anda tanpa harus belajar alat video terpisah.
Langkah-Langkah Praktis Mengoptimalkan Prompt agar Hasil Lebih Tajam
Prompt yang baik bukan sekadar kalimat deskriptif; ia harus menyertakan detail teknis yang memberi petunjuk jelas kepada model. Mulailah dengan menentukan format output, misalnya “4K ultra‑high‑definition”, kemudian tambahkan kata kunci gaya seperti “cinematic lighting” atau “hyper‑realistic texture”. Detail ini membantu AI menyeimbangkan elemen estetika dan resolusi secara bersamaan.
Berikut adalah urutan langkah praktis yang dapat Anda ikuti:
- Spesifikasikan resolusi dan rasio aspek. Tuliskan “1920×1080, landscape” untuk memastikan gambar tidak terpotong secara otomatis.
- Gunakan kata sifat yang mengarahkan cahaya. Istilah seperti “soft shadows”, “golden hour lighting”, atau “backlit silhouette” memberi petunjuk pencahayaan yang kritis bagi ketajaman visual.
- Masukkan referensi gaya atau artis. Contoh: “in the style of Greg Rutkowski” atau “reminiscent of Studio Ghibli” memperkaya konten dengan pola warna dan tekstur yang sudah teruji.
- Tambahkan instruksi post‑processing. Frasa “high contrast, sharp focus, 2‑point perspective” memberi sinyal kepada model untuk menajamkan detail pada akhir proses.
Langkah‑langkah di atas meningkatkan kemungkinan hasil akhir yang tajam, terutama ketika Anda menggunakan model diffusion yang sensitif terhadap detail pencahayaan. Berdasarkan pengalaman praktisi, gambar yang diproses dengan prompt terstruktur dapat mengurangi kebutuhan revisi sebanyak 45 % dibandingkan prompt yang hanya berisi deskripsi umum.
Menggunakan kombinasi kata kunci yang tepat juga meminimalkan kesalahan interpretasi. Sebagai contoh, menambahkan “no background” pada prompt akan mencegah AI menambahkan elemen lingkungan yang tidak diinginkan, sehingga fokus utama tetap pada subjek utama. Ini sangat penting ketika Anda mengintegrasikan gambar ke dalam layout web atau presentasi bisnis.
Baca Juga: AI untuk SEO: Tingkatkan Peringkat lewat Analisis Kata Kunci
Kesalahan Umum dalam Membuat Gambar AI dan Cara Menghindarinya
Salah satu jebakan paling umum adalah over‑generalisasi prompt. Pengguna yang menulis “pemandangan indah” tanpa menyertakan detail spesifik sering kali mendapatkan gambar yang tampak generik dan kurang menonjol. Menghindari hal ini berarti menambahkan elemen spesifik seperti “pohon sakura di tepi danau berwarna biru pastel pada sore hari”.
Kesalahan kedua ialah melupakan batasan model. Model tertentu memiliki batas maksimum token atau panjang prompt; melebihi batas tersebut dapat memotong bagian penting dan menghasilkan output yang tidak lengkap. Periksa dokumentasi model sebelum menulis prompt panjang.
Terakhir, banyak kreator tidak memperhatikan hak cipta data training. Menggunakan gaya artis yang sangat identik tanpa menambahkan transformasi signifikan dapat menghasilkan gambar yang dianggap plagiarisme. Selalu tambahkan modifikasi atau kombinasi gaya untuk menjaga orisinalitas dan menghindari pelanggaran.
Tips Praktis dari Praktisi Berpengalaman untuk Mempercepat Proses
Pengalaman lapangan menunjukkan bahwa otomatisasi batch processing bisa menghemat hingga 30 % waktu kerja. Misalnya, dengan skrip Python yang mengirimkan serangkaian prompt ke API Stable Diffusion secara paralel, Anda dapat menghasilkan 50 gambar dalam hitungan menit, dibandingkan dengan proses manual satu per satu.
Selain itu, simpan koleksi prompt “template” yang sudah teruji. Ketika proyek baru muncul, Anda cukup menyesuaikan beberapa kata kunci saja, alih‑alih menulis prompt dari nol. Ini tidak hanya mempercepat produksi, tetapi juga meningkatkan konsistensi visual di seluruh portofolio Anda.
Jika Anda mengerjakan proyek yang memerlukan variasi warna, gunakan parameter “seed” yang sama dengan mengubah hanya prompt warna. Hal ini memungkinkan Anda membandingkan alternatif warna tanpa mengulang proses rendering dari awal, sehingga mempercepat iterasi desain.
Pertanyaan yang Sering Ditanyakan tentang Membuat Gambar AI
Apakah saya membutuhkan perangkat keras khusus? Umumnya, model diffusion dapat dijalankan pada GPU dengan memori 8 GB, meskipun performa lebih baik pada 12 GB atau lebih. Layanan cloud menyediakan alternatif bila perangkat lokal tidak memadai.
Berapa lama proses rendering? Waktu bervariasi tergantung resolusi dan model; untuk 512×512 pada Stable Diffusion, rata‑rata 5‑10 detik per gambar, sedangkan 4K dapat memakan 30‑45 detik.
Apakah bisa mengedit gambar setelah dihasilkan? Ya, Anda dapat menggunakan software editor seperti Photoshop untuk sentuhan akhir, atau kembali ke model dengan “img2img” untuk memperbaiki area tertentu.
Bagaimana cara menghindari bias visual? Pilih dataset training yang beragam dan gunakan prompt yang inklusif. Beberapa platform menyediakan filter bias untuk membantu mengurangi representasi yang tidak seimbang.
Kesimpulan: Langkah Selanjutnya untuk Menghasilkan Gambar AI Berkualitas Tinggi
Memasuki fase implementasi, fokuskan upaya pada kombinasi model yang tepat, prompt yang terstruktur, dan praktik kerja yang efisien. Dengan mengintegrasikan tip‑tip di atas, Anda dapat meningkatkan produktivitas visual secara signifikan sambil menjaga standar kualitas yang tinggi. Selanjutnya, eksperimenlah dengan variasi gaya, resolusi, dan teknik post‑processing untuk menemukan kombinasi yang paling sesuai dengan target audiens Anda, sambil tetap memperhatikan kebijakan hak cipta dan etika penggunaan AI.